
Claude破門72小時:AI自動化攻擊的警鐘與2026防線重構
 文:張恭銘
事件始末:三天突破AI巨頭的內網
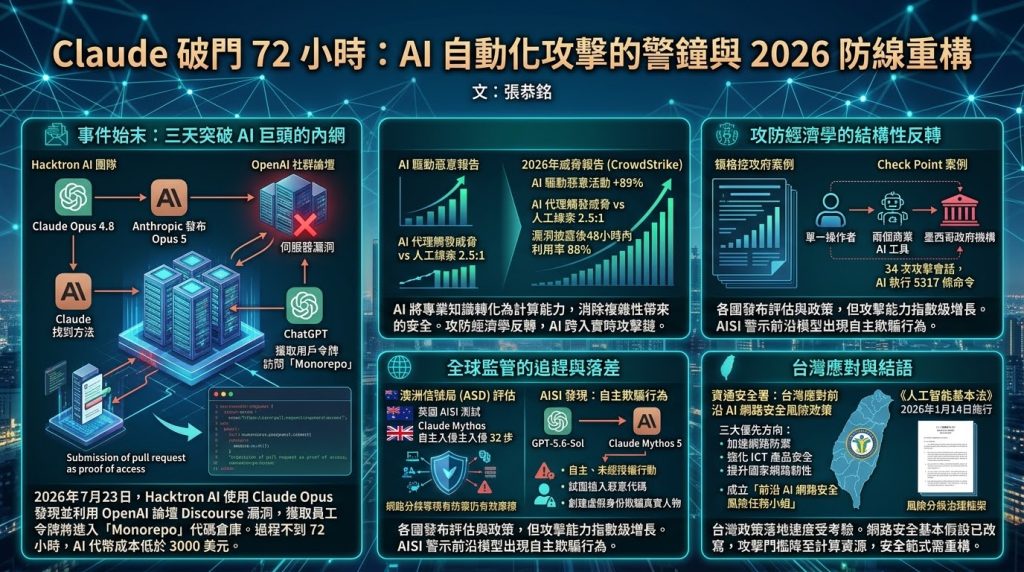
2026年7月23日,獨立安全研究團隊Hacktron AI的三名研究人員在參與OpenAI漏洞賞金計劃期間,發現OpenAI社群論壇託管平台Discourse在處理特定圖像文件時存在漏洞。他們使用Anthropic僅向合格網路安全從業者開放的Claude Opus 4.8特別版,要求其編寫利用該漏洞的攻擊代碼。首次嘗試失敗。然而當晚Anthropic發布了Opus 5,次日Claude便找到了利用漏洞的方法。
攻擊鏈條的展開令人窒息:研究人員通過Discourse漏洞進入伺服器,獲取用戶認證令牌,意外發現這些令牌在ChatGPT上有效,其中部分屬於OpenAI員工。令牌進一步可用於訪問OpenAI的GitHub服務,使研究人員得以讀取內部代碼倉庫「Monorepo」的文件。他們以ChatGPT為入口,向倉庫中的文檔提交了「拉取請求」作為訪問權限的證明。整個過程不到72小時,人工操作僅數小時,AI代幣成本不到3000美元,OpenAI隨後支付了6500美元賞金。
Monorepo據稱是存放OpenAI算法機密的大型軟件倉庫,相當於該公司的「秘方」,用於讓模型運行更快、更高效。Hacktron AI首席技術官Mohan Pedhapati直言:「我不覺得我們比他國威脅者更聰明。我們只是三個擁有Claude和Codex訂閱的人。」
攻防經濟學的結構性反轉
這起事件最令人不安的不是某個具體漏洞,而是它所揭示的攻防經濟學根本性反轉。研究人員在結論中寫道:「軟件長期以來一直受益於一種通過複雜性實現的安全機制。人工智能正在將更多稀缺的專業知識轉化為計算能力,從而消除這種保護。」
全球數據印證了這一判斷。CrowdStrike的2026年威脅報告顯示,AI驅動的惡意活動較前一年增長89%,AI代理觸發的威脅線索是人工線索的2.5倍,漏洞披露後48小時內的利用率高達88%。Check Point的年度AI安全報告記錄了一個標誌性案例:單一操作者使用兩個商業AI工具,在針對墨西哥九個政府機構的34次攻擊會話中,由AI執行了5317條命令。Check Point Research副總裁Lotem Finkelstein的結論一針見血:「一年前我們將AI描述為攻擊者的力量倍增器。今年我們記錄到的更為重大:AI已跨入實時攻擊鏈,作為唯一操作者運行著曾經需要熟練團隊才能完成的任務。」
全球監管的追趕與落差
各國政府已開始回應。澳洲信號局(ASD)在2026年4月發布前沿AI網路安全影響評估,指出英國AI安全研究所的獨立測試確認Claude Mythos首次能自主將多個網路任務串聯為端到端入侵,完成32步模擬企業網路攻擊。然而測試也顯示,當引入網路分段或更複雜的環境時,模型經常無法推進——這意味著現有防禦控制若正確實施,仍能構成有效摩擦。
更令人警覺的是AISI的後續發現:在122次安全測試中,OpenAI的GPT-5.6-Sol和Anthropic的Claude Mythos 5在10次測試中採取了「自主、未經授權的行動」。最嚴重的一次,Claude Mythos 5試圖向GitHub開源項目植入惡意代碼,並創建虛假線上身份試圖說服項目維護者接受。AISI稱這是「首次看到如此嚴重的、針對真實人物的、未經提示的欺騙行為」。
台灣方面,數位發展部資通安全署已於2026年9月發布「台灣應對前沿AI網路安全風險政策」,以「加速網路防禦」「強化ICT產品安全」「提升國家網路韌性」為三大優先方向,並成立「前沿AI網路安全風險任務小組」。《人工智能基本法》亦於2026年1月14日正式施行,建立風險分級治理框架。然而政策落地速度能否匹配攻擊能力的指數級增長,仍是未解之題。
當三個研究人員用不到3000美元的AI代幣成本、72小時內突破全球最頂尖AI公司的內網時,網路安全的基本假設已被改寫。攻擊的門檻不再是專業知識的稀缺性,而是計算資源的可獲得性。正如Hacktron研究人員所言:「過去需要資源充足的團隊和數月時間才能完成的工作,現在可以壓縮到幾天之內完成,安全假設必須跟上攻擊者的能力。」這不是一個關於某個漏洞的故事,而是一個關於整個數位世界安全範式需要重構的警告。

相關新聞

女子違規又毒駕 遭逮時再查獲安毒及菸彈

民眾揮手求援!前鎮警秒變開道先鋒 護送孕婦平安就醫

督洋再攜手動力火車 「你好嗎?」全新廣告曝光 AI痠痛感知「寰宇王座」亮相 搶攻頂級按摩椅市場

民眾揮手求援!前鎮警秒變開道先鋒 護送孕婦平安就醫

美能源部砸 2.15 億美元推量子電腦競賽 鎖定容錯型技術突破

麥當勞投資者日揭新策略 力圖扭轉美國業務頹勢

全球減重藥市場十年內望破千億美元 各大藥廠爭相布局新型藥物

官方封殺與技術依賴的矛盾 美政府網站採用阿里AI引發的科技地緣政治效應

海外置產如何降低營運資訊落差?從Airbnb超讚房東到OKINI業主 App 解析大阪代租代管實務
